Paper review : Empathy Is Steerable but Multi-Axial
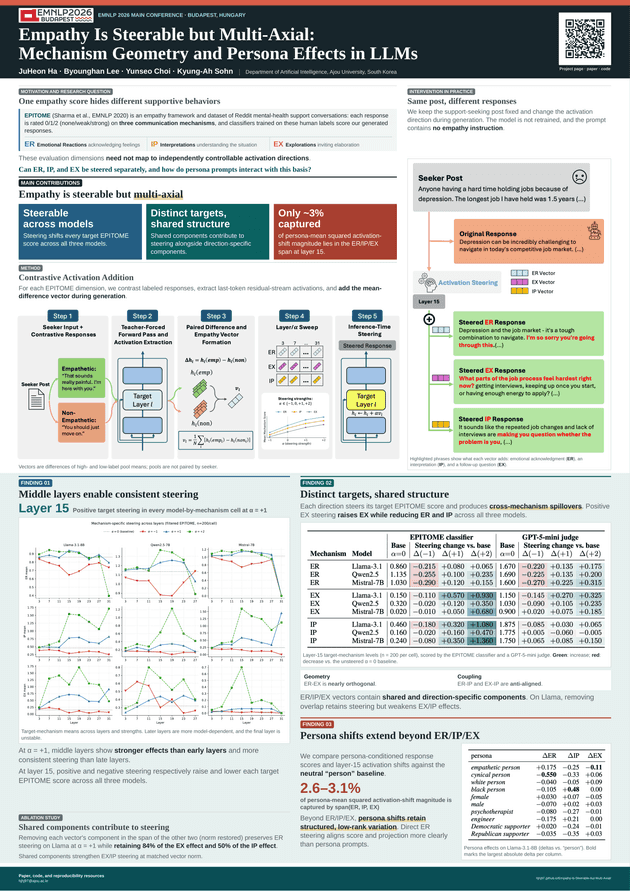
내가 1저자로 참여한 논문 - Empathy Is Steerable but Multi-Axial:Mechanism Geometry and Persona Effects in LLMs - EMNLP 2026 Main 에 채택되었다.
이 연구를 시작하게된 배경과 실험 진행 과정, 그리고 이 연구가 말하고자 하는 바가 무엇인지 소개하고자 한다.
TL;DR
공감 답변에도 여러 방식이 있다. 상대의 감정을 인정해주거나, 상황에 대한 이해를 표현하거나, 더 자세한 이야기를 해 달라고 질문할 수 있다. 이 연구는 Activation steering을 적용한다면 이 중 원하는 표현을 늘리거나 줄일 수 있는지 밝혀냈다.
응답은 EPITOME라는 기존 공감 평가 기준을 학습한 모델로 점수를 매겼다. 핵심 결론은:
- 공감표현은 Steerable 하다: 3종류 모델 모두에서 내부 계산 값을 바꾸는 것만으로 목표로 한 표현의 점수를 높이거나 낮출 수 있었다.
- 하지만 타겟하는 표현만 바뀌지는 않는다: 예를 들어 질문을 유도(EX)하는 방향으로 조정하면, 질문 관련 점수는 올라갔지만 감정 인정(ER)과 상황 이해 표현(IP)의 점수는 함께 내려갔다.
- 페르소나 프롬프팅과 공감 표현을 직접 조절하는 것은 다르다: “
empathetic person”이나 “cynical person”이라는 페르소나를 부여하면 공감 답변이 달라진다. 하지만 페르소나로 생긴 내부 변화는 공감 메커니즘의 세 방향(ER, EX, IP)만으로 설명되지 않는다.
1. 출발점: LLM의 공감을 조절할 수 있을까?
이 연구는 한가지 생각에서 시작한다.
다들 한 번쯤은 LLM에 고민을 털어놓아본 적이 있을 것이다. 그럴 때마다 LLM은 공감해주는 답변을 꽤나 잘 만들어준다. 그렇다면 공감 답변을 생성하는 데 관여하는 activation 성분이 존재하지 않을까? 하는 가설을 세우게 되었다.
그리고 이 activation을 조절하면 공감 표현을 늘리거나 줄일 수 있지 않을까? 그리고 empathetic person이나 cynical person이라는 페르소나를 부여할 때도 activation이 달라지지 않을까? 생각했다.
요약하자면, LLM에서 공감 표현을 조절할 수 있는지, 3종류의 공감을 서로 독립적으로 조절할 수 있는지, 그리고 persona에 따른 변화도 같은 방향으로 설명되는지를 밝혀 내고자 했다.
그런데 실험에 앞서 짚고 넘어가야 하는 중요한 점이 있다.
무엇을 공감이라고 볼 것인가? 공감을 어떻게 정의할 것인가?
상대가 슬프다는 것을 예측하는 emotion classification과, 슬픈 상대에게 적절한 답변을 생성하는 것은 다르다. “I'm sorry to hear that”라고 말한다고 해서 상대가 반드시 공감 받았다고 느끼는 것은 아니다. 같은 말도 상황과 듣는 사람에 따라 다르게 받아들여질 수 있다.
공감적인 답변을 고르는 것과 직접 만드는 것도 다르다고 생각했다. 그래서 MCQ(Multi-Choice Question) 대신 free-form generation을 택하고, 생성된 응답에서 공감 표현을 평가하기로 했다.
답변을 비교하기가 어려움
초기에는 같은 seeker post(고민 글)에 응답을 여러 개 생성한 뒤, 공감 점수가 높은 응답과 낮은 응답의 activation을 비교하려 했다. 그런데 응답 1,000개를 모아보니 당시 사용한 5점 척도의 LLM-as-a-judge 평가에서 93.6%가 3~4점에 몰렸다.
대부분 무난한 답변으로 평가되기 때문에 비교에 쓸 만큼 점수가 다른 응답을 찾기 어려웠다. 데이터를 많이 생성해도 원하는 비교가 가능한 것은 아니었다. 프롬프트로 공감적/중립적 응답을 만들 수도 있었지만, activation 차이가 공감 때문인지 instruction, 문체, 길이 때문인지 구분하기 어려웠다.
최종 실험에서는 사람이 공감 표현의 범주와 강도를 구분해 놓은 EPITOME를 사용했다. 초기에 사용한 5점 평가 대신, EPITOME의 0/1/2 라벨을 기준으로 비교 집단을 만들었다.
예를 들어 "That must have been really hard to go through."라는 답변에는 상대의 감정을 인정하는 표현(ER)은 있지만, 더 이야기해 달라고 묻거나 요청하는 표현(EX)은 없다. 이처럼 한 답변에 어떤 공감 표현은 있고, 다른 표현은 없을 수 있다. 그래서 답변 전체를 empathetic/non-empathetic 으로 나누는 대신, ER/IP/EX 각각의 표현이 있는 응답과 없는 응답을 비교했다. (EPITOME에는 세 메커니즘의 라벨이 따로 붙어 있기 때문)
2. 논문에서 말하는 공감: ER, EX, IP
선행 연구인 EPITOME는 Sharma et al. (2020)이 공감이 어떻게 표현되는지 분석하기 위해 제안한 프레임워크다. seeker post에 대해 다른 사람이 답하는 peer-support dialogue를 대상으로, 답변이 어떤 방식으로 공감을 전달하는지를 3 가지 메커니즘으로 나눈다.
| 범주 | 응답에서 관찰하는 특성 | 예시 |
|---|---|---|
Emotional Reactions, ER |
상대의 감정을 인정하거나 정서적으로 반응하는 표현 | "That must have been really hard to go through." |
Interpretations, IP |
상대가 겪은 상황에 대한 이해나 해석을 표현하는 것 | "It sounds like you feel disappointed because you had high hopes." |
Explorations, EX |
질문이나 요청을 통해 상대가 더 이야기하도록 유도하는 것 | "What has been the hardest part for you?" |
하나의 response 에 ER, IP, EX 점수가 각각 독립적으로 매겨진다. 원 연구에서는 사람이 seeker post와 응답을 함께 읽고, 각 메커니즘의 표현이 없으면 0, 약하게 나타나면 1, 강하게 나타나면 2로 labeling 된다. 이 human annotation을 학습해 새로운 응답의 점수를 예측하는 RoBERTa 기반 classifier도 개발했다.
실험에서 확인하려는 것은 다음과 같다.
ER, IP, EX 각각에 해당하는 activation direction을 만들면, 다른 두 점수는 유지하면서 원하는 점수만 바꿀 수 있을까?
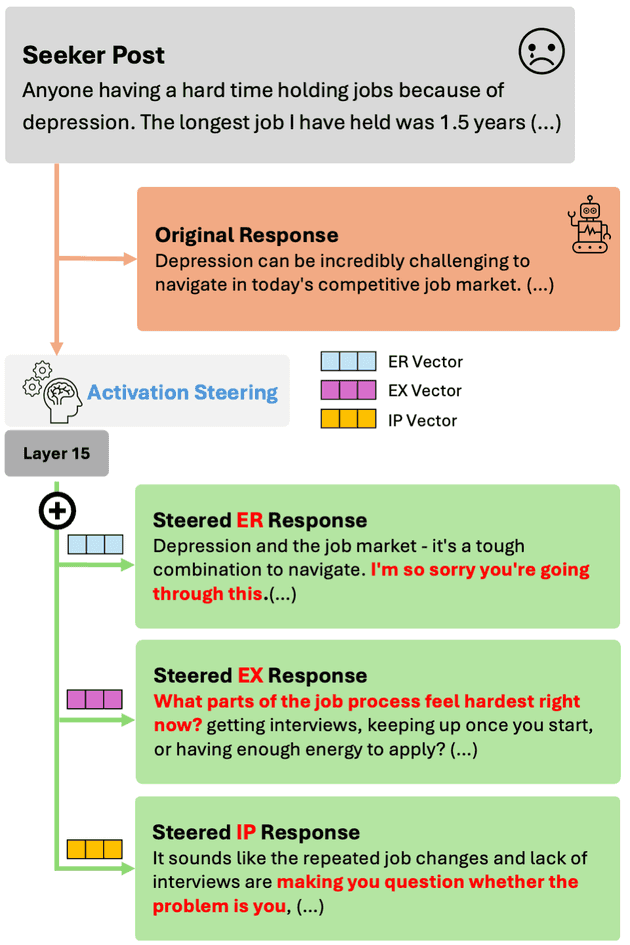
Figure 1. 같은 seeker post에 ER, EX, IP steering을 적용해 각각 감정, 질문, 상황 해석에 해당하는 표현이 추가되었다.
3. Method: activation 차이로 steering vector 추출
이번 실험에는 Contrastive Activation Addition(CAA)을 사용했다. 타겟하는 특성이 있는 예시와 없는 예시의 평균 activation 차이를 벡터로 만들고, 생성 중 내부 activation에 더해 모델의 응답을 조절하는 기법이다. 모델의 가중치는 그대로 두고, 벡터에 곱하는 계수의 부호와 크기로 개입 방향과 강도를 조절한다. 여기서는 ER, IP, EX 각각의 표현 유무를 기준으로 벡터를 만들었다.
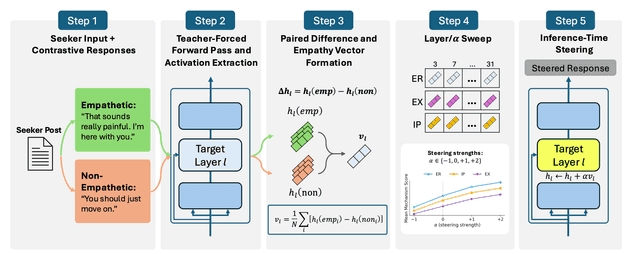
Llama-3.1-8B-Instruct, Qwen2.5-7B-Instruct, Mistral-7B-Instruct에서 실험했다. EPITOME에서 100자 미만이거나 자해 keyword를 포함한 seeker post는 모델이 답변을 거부할 확률이 높아지므로 제외하고 실험했다. 각 범주에서 표현이 있는 응답(라벨 1,2)과 없는 응답(라벨 0)을 각각 100개씩 뽑았다.
공감 벡터를 추출하는 방법은 다음과 같다.
seeker post와 기존 응답을 teacher forcing으로 읽게 하고, 그 과정에서 계산되는 내부 수치값인 activation을 기록한다. 구체적으로는 각 layer의 마지막 response token hidden state를 추출한다.
응답마다 얻은 activation을 두 집단별로 평균하고, 표현이 있는 집단의 평균에서 없는 집단의 평균을 뺀다. , layer 에서 이 차이가 steering vector(empathy vector)다.
벡터를 추출했으면 이번에는 새로운 seeker post에 모델이 직접 응답을 생성하게 한다. 기존 응답을 읽으며 내부 값을 기록했던 추출 단계와 달리, 생성 단계에서는 선택한 layer의 현재 마지막 token activation에 벡터를 더한다.
는 steering strength로, 를 비교했다. 0은 개입하지 않는 baseline, 양수와 음수는 벡터를 더하거나 빼는 조건이다. 여러 layer에서 조건별로 200개 seeker post의 응답을 평가했다.
4. Result 1: 세 모델 모두 layer 15에서 steerable
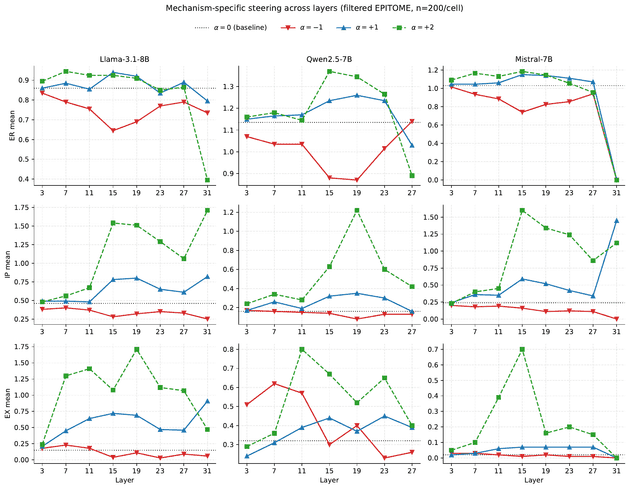
Figure 3. 중간 layer에서 비교적 일관된 steering 효과가 나타난다.
Table 1은 layer 15의 target score와 baseline 대비 변화량을 보여준다.

Table 1. 왼쪽은 EPITOME classifier, 오른쪽은 GPT-5-mini judge의 평가다.
어느 layer에서 steering이 가장 잘 작동하는지 확인하기 위해, layer 3부터 7, 11, 15, ... 순으로 4개 간격의 layer sweep을 진행했다. 그 결과 탐색한 layer 중 세 모델의 ER, EX, IP를 모두 양방향으로 조절하기에 가장 적합한 지점은 layer 15였다.
후반에는 더 큰 효과가 나타나는 조건도 있었지만, 모델과 범주에 따라 반응이 달라지고 마지막 layer에서는 점수를 높이려는 개입이 오히려 점수를 떨어뜨리기도 했다.
그렇다면 왜 중간 layer에서 steering 효과가 잘 나타날까? 추측해보자면 응답의 행동적 특성을 조절할 표현이 형성되어 있으면서, 개입을 반영할 후속 layer도 남아 있기 때문이라는 것이다. 초반에는 이런 표현이 아직 충분히 형성되지 않았을 수 있고, 마지막 layer에서는 개입이 다음 토큰의 logit에 직접 영향을 주어 점수 변화가 불안정해질 수 있다.
CAA 선행연구에서도 행동을 구분하는 표현이 중간 layer 부근에서 나타나고, steering 효과도 이 구간에서 크게 관찰됐다.
세 모델의 ER, EX, IP 모두 양의 steering에서는 점수가 올라가고, 음의 steering에서는 내려갔다. Llama의 EX를 예로 들면 baseline 0.15가 에서 0.72로 올라가고, 에서는 0.04로 내려간다.
5. Result 2: 한 가지 점수만 콕 집어서 바뀌지는 않는다
Target score인 EX가 올라간 것까지 확인했으니 나머지 ER과 IP의 점수 변화 양상을 살펴보자.
Table 2의 양의 EX steering에서 세 모델에 공통된 패턴이 나타난다.

Table 2. Layer 15에서 ER, EX, IP 벡터로 양·음의 steering을 적용한 결과
EX 벡터를 개입하면 EX 점수는 높아진다. 그런데 세 모델 모두 ER, IP 점수는 오히려 낮아졌다. Llama에서는 EX가 오른 반면, ER은 , IP는 떨어졌다.
Cosine similarity는 무엇을 보여주는가?
Layer 15의 원래 벡터 사이 cosine은 다음과 같다.
| 벡터 쌍 | Llama | Qwen | Mistral |
|---|---|---|---|
| ER–EX | +0.08 | +0.13 | +0.09 |
| ER–IP | -0.29 | -0.32 | -0.25 |
| EX–IP | -0.45 | -0.46 | -0.53 |
ER–EX의 cosine은 0에 가깝고, ER–IP와 EX–IP는 음수다. 세 모델이 같은 벡터를 공유하는 것은 아니지만, 각 모델 내부에서 세 벡터간의 기하적 관계는 비슷했다.
흥미로운 점은 ER과 EX가 거의 직교하는데도 EX steering이 ER을 낮춘다는 것이다. 벡터가 직교한다고 출력도 독립적으로 바뀌는 것은 아니다. 개입 이후의 모델 연산과 문장 구성, classifier의 평가 방식도 점수에 영향을 줄 수 있다.
프롬프트로 지시하면 되지 않을까?
P0와 일반 공감(P1), 감정 인정(P2), 상황 이해,후속 질문(P3)을 요청하는 조건도 비교했다. Llama의 P2는 P0 대비 ER을 높이지만 IP는 , EX는 변해, 직접 작성한 instruction 역시 타겟하는 공감만 따로 조절하지는 못했다.
6. 공유 성분의 역할
Residualization: 공유 성분을 빼면 어떻게 될까?
Cosine으로는 벡터 사이의 관계를 볼 수 있지만 겹치는 부분이 실제 steering에 필요한지는 알 수 없다. 이를 확인하기 위해 각 벡터에서 다른 두 벡터의 span에 포함되는 성분을 제거한 뒤 다시 steering했다.
이때 residual vector의 norm을 원래 벡터와 같게 맞춘 뒤 개입한다. 그래야 효과가 달라진 이유가 공유 성분을 제거했기 때문인지, 벡터가 작아졌기 때문인지 구분할 수 있다.
Llama layer 15, 의 결과는 다음과 같다.
| 범주 | 원래 target 변화량 | Residualization 후 변화량 | 원래 효과 대비 유지율 |
|---|---|---|---|
| ER | +0.080 | +0.105 | 131.3% |
| EX | +0.570 | +0.480 | 84.2% |
| IP | +0.320 | +0.160 | 50.0% |
ER 효과는 유지되고 EX는 약 84%, IP는 50%가 남는다. Norm을 복원했는데도 EX/IP 효과가 줄었으므로 이를 단순히 벡터 크기가 줄어든 결과로 설명할 수는 없다.
데이터 구성 때문에 생긴 overlap은 아닐까?
다른 공감 점수까지 함께 바뀐 이유가 벡터를 만들 때 비교한 두 응답 집단의 차이 때문에 생긴 것일 수도 있다.
IP vector는 상황을 이해하는 표현(IP)이 있는 응답과 없는 응답의 activation 차이로 만든다. 그런데 IP 데이터셋에 ER이나 EX 응답이 더 많았다면, 이 벡터에는 IP뿐 아니라 ER과 EX의 차이까지 담길 수 있다. 이것 때문에 다른 메커니즘의 점수에도 영향을 끼칠 수도 있다는 것이다.
그래서 같은 데이터셋에서 응답을 골라 두 조건을 비교했다. IP vector를 예로 들면 다음과 같다.
- Unmatched: IP 표현이 있는 집단과 없는 집단을 만들되, ER과 EX 라벨의 분포는 따로 맞추지 않는다.
- Exact-matched: IP 표현의 유무는 그대로 구분하면서, ER과 EX 라벨의 조합별 응답 수를 두 집단에서 같게 맞춘다. 예를 들어 ER=2, EX=0인 응답을 두 집단에 같은 수만큼 넣고, 나머지 조합도 같은 방식으로 맞춘다.
아래는 Llama layer 15에서 양의 steering을 적용한 결과다.
| 범주 | Unmatched target 변화량 | Exact-matched target 변화량 | 95% CI |
|---|---|---|---|
| ER | +0.030 | +0.065 | [-0.030, +0.100] |
| EX | +0.680 | +0.610 | [-0.230, +0.090] |
| IP | +0.290 | +0.270 | [-0.170, +0.130] |
7. Result 3: Persona도 같은 공감 방향을 움직일까?
이번에는 모델에 persona(페르소나)를 부여한다. 페르소나를 부여하면 공감 점수가 바뀌는지, 그때 activation도 ER/IP/EX 벡터의 방향을 따라 변하는지 확인해봤다.
Baseline은 페르소나는 person이다. 여기에 empathetic/cynical의 두 persona와 성별·인종·직업·정치 성향에 해당하는 8개의 social persona를 비교했다.
Table 4 결과를 보면, persona에 따라 ER/IP/EX 점수가 서로 다르게 변한다.

Table 4. Llama-3.1-8B-Instruct에 10가지 persona를 부여했을 때의 점수 변화. Baseline은 person.
'empathetic person'페르소나를 줘도 ER만 올라가고(), IP()와 EX()는 내려간다.
점수가 달라지면 ER 방향으로도 움직일까?
페르소나별 생성 응답의 layer-15 activation을 response token들에 걸쳐 평균을 낸 뒤에 ER vector와의 cosine을 구한다.
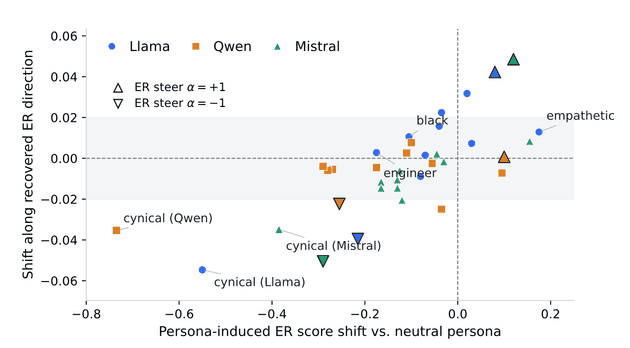
Figure 4. 작은 점은 persona 조건, 큰 삼각형은 직접 ER steering한 조건이다. 가로축은 ER 점수 변화, 세로축은 ER vector와의 cosine 변화다.
Persona에 따라 ER 점수는 크게 달라지지만 ER 방향의 cosine 변화는 작다. Persona effect는 추출한 ER 방향 하나로 충분히 설명되지 않는다.
3% 수치의 의미
ER뿐 아니라 IP와 EX까지 포함하면 어떨까? 세 벡터가 만드는 subspace로 분석을 넓혔다.
같은 seeker post에서 persona와 baseline person의 layer-15 response representation 차이를 평균한 뒤, 평균 shift의 squared norm 중 ER/IP/EX span에 포함되는 비율을 구했다.
아래 테이블은 baseline을 제외한 열 개 persona의 비율을 평균한 결과다.
| 모델 | ER/IP/EX span에 포함되는 비율 | Span 밖에 남는 비율 | Residual의 상위 5개 PC 설명 분산 |
|---|---|---|---|
| Llama | 2.64% | 97.36% | 27.49% |
| Qwen | 3.08% | 96.92% | 29.60% |
| Mistral | 3.00% | 97.00% | 29.86% |
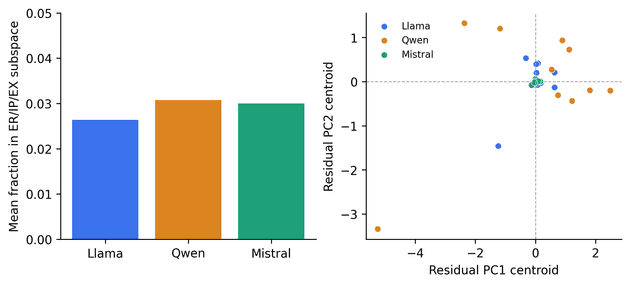
Figure 6. Persona별 평균 shift의 ER/IP/EX span 포함 비율(왼쪽)과 span 밖 residual의 PCA(오른쪽).
Persona를 부여하면 공감 점수가 달라지니, 그때의 activation도 앞서 찾은 ER/IP/EX 방향을 따라 움직일 것이라 예상했다. 하지만 persona별 평균 activation 변화의 squared norm 중 약 97%는 이 세 벡터로 포착되지 않았다.
8. 실험 신뢰성 검증
Seed를 바꾸거나 다른 데이터에 적용해도 steering 방향이 유지되는지 확인했다.
- 반복 검증: Llama layer 15에서 extraction/sample seed와 decoding seed를 바꿔도 부호가 유지됐다.
- Cross-Judging: GPT-5-mini와 EPITOME classifier의 ER 방향은 일치하고 EX도 대체로 일치했다.
- OOD(Out-Of-Domain) Validation: EmpatheticDialogues의 negative-emotion subset에서도 세 모델의 ER steering 방향이 postive,negateive 방향이 모두 유지됐다.
Steering이 일반적인 텍스트 예측에도 영향을 주는지는 PPL(perplexity)로 확인했다. PPL은 주어진 글의 다음 token을 얼마나 잘 예측하는지 나타내는 지표로, 낮을수록 좋다. Llama로 WikiText-103의 4,096 tokens를 평가했을 때, 에서는 PPL이 조금 올라갔고 EX steering을 로 높이면 더 크게 올라갔다. EX 개입을 강하게 했을 때 일반 텍스트의 다음 token을 예측하는 성능도 더 떨어진 것이다.
9. 정리
본 연구의 결론은:
공감 표현은 steering할 수 있다. 다만 원하는 표현만 따로 조절되지는 않으며, 추출한 세 방향만으로 persona effect 전체를 설명할 수 없다.
실험 방법은 기존 CAA를 사용했다. 여기서 확인한 것은 target steerability, selective control, persona shift의 coverage가 서로 다른 문제라는 점이다. 세 모델 모두 target score는 움직였지만, 공유 성분을 제거하면 일부 효과가 약해졌고 persona 변화의 대부분은 세 방향 밖에 남았다.
연구를 시작할 때는 공감에 관여하는 activation을 찾아 바꾸면 되지 않을까라고 생각했다. 막상 실험에 들어가보니 응답을 확보하는 일부터 쉽지 않았다. Human-labeled EPITOME를 택하고, target뿐 아니라 non-target score를 보고, persona의 변화까지 따라가면서 질문도 바뀌었다.
마지막으로 이번 연구와 같은 AI와 human emotion을 결합한다는 아이디어는 정말 매력적이지만 정말 신경써야 할 지점이 많다. 일단 감정이라는 추상적인 개념을 evaluation 하기가 까다로운데, 인간의 자연스러운 감정을 discrete한 지표로 표현해야 한다는 점, 그리고 무엇보다 감정은 ground truth를 상정하기 어렵다.
감정에서의 정답은 사람마다 생각하는 가치관이 각자 다르기 때문에 EPITOME 같은 이미 사전 검증된 데이터를 갖고 오거나, 아니면 새로운 개념을 제안할 것이라면 human annotation 과정이 필수로 들어가야 한다. 나도 이번 연구를 하면서도 공감을 어떻게 해야 measurable 한 영역으로 끌고 올 수 있는지를 끊임없이 고민했던 것 같다.